LangChain
markdown sourceLangChain - это мощная и удобная Python-библиотека для создания приложений на основе языковых моделей. Она обеспечивает простой способ интеграции LLM с инструментами, памятью и работает с множеством провайдеров моделей.
Основные возможности
LangChain предлагает:
- Интеграцию с различными языковыми моделями (OpenAI, Google Gemini, Claude, Ollama и др.)
- Создание агентов, которые могут использовать инструменты для выполнения задач
- Управление памятью для сохранения контекста разговоров
- Работу с документами и извлечение информации
- Трассировку с помощью LangSmith
Создание базового агента
Вот простой пример создания агента с использованием OpenAI:
from langchain.agents import create_agent

def get_weather(city: str) -> str:
    """Получить погоду для города."""
    return f"В {city} всегда солнечно!"

agent = create_agent(
    model="openai:gpt-5.5",
    tools=[get_weather],
    system_prompt="Ты полезный ассистент",
)

result = agent.invoke(
    {"messages": [{"role": "user", "content": "Какая погода в Санкт-Петербурге?"}]}
)
print(result["messages"][-1].content_blocks)
Создание реального агента с инструментами
Определение системного промпта
Системный промпт определяет поведение вашего агента. Сделайте его конкретным и действенным:
SYSTEM_PROMPT = """Ты литературный ассистент для анализа данных.

## Возможности

- `fetch_text_from_url`: загружает текст документа с URL в диалог.
Не угадывай количество строк или позиции — получай их из результатов инструментов."""
Создание инструментов
Инструменты позволяют модели взаимодействовать с внешними системами. Используйте декоратор @tool:
import urllib.error
import urllib.request
from langchain.tools import tool

@tool
def fetch_text_from_url(url: str) -> str:
    """Загружает документ с URL."""
    req = urllib.request.Request(
        url,
        headers={"User-Agent": "Mozilla/5.0 (quickstart-research/1.0)"},
    )
    try:
        with urllib.request.urlopen(req, timeout=120) as resp:
            raw = resp.read()
    except urllib.error.URLError as e:
        return f"Ошибка загрузки: {e}"
    text = raw.decode("utf-8", errors="replace")
    return text
Конфигурация модели
Настройте модель с нужными параметрами:
from langchain.chat_models import init_chat_model

model = init_chat_model(
    "openai:gpt-5.5",
    temperature=0.5,
    timeout=300,
    max_tokens=25000,
)
Добавление памяти
Добавьте память для сохранения состояния между взаимодействиями:
from langgraph.checkpoint.memory import InMemorySaver

checkpointer = InMemorySaver()
Создание и запуск агента
Соберите агент со всеми компонентами:
from langchain.agents import create_agent
from deepagents import create_deep_agent

agent = create_agent(
    model=model,
    tools=[fetch_text_from_url],
    system_prompt=SYSTEM_PROMPT,
    checkpointer=checkpointer,
)

# Или используйте Deep Agent
deep_agent = create_deep_agent(
    model=model,
    tools=[fetch_text_from_url],
    system_prompt=SYSTEM_PROMPT,
    checkpointer=checkpointer,
)

result = agent.invoke(
    {"messages": [{"role": "user", "content": "Вопрос для анализа..."}]},
    config={"configurable": {"thread_id": "my-session"}},
)
print(result["messages"][-1].content_blocks)
Agents
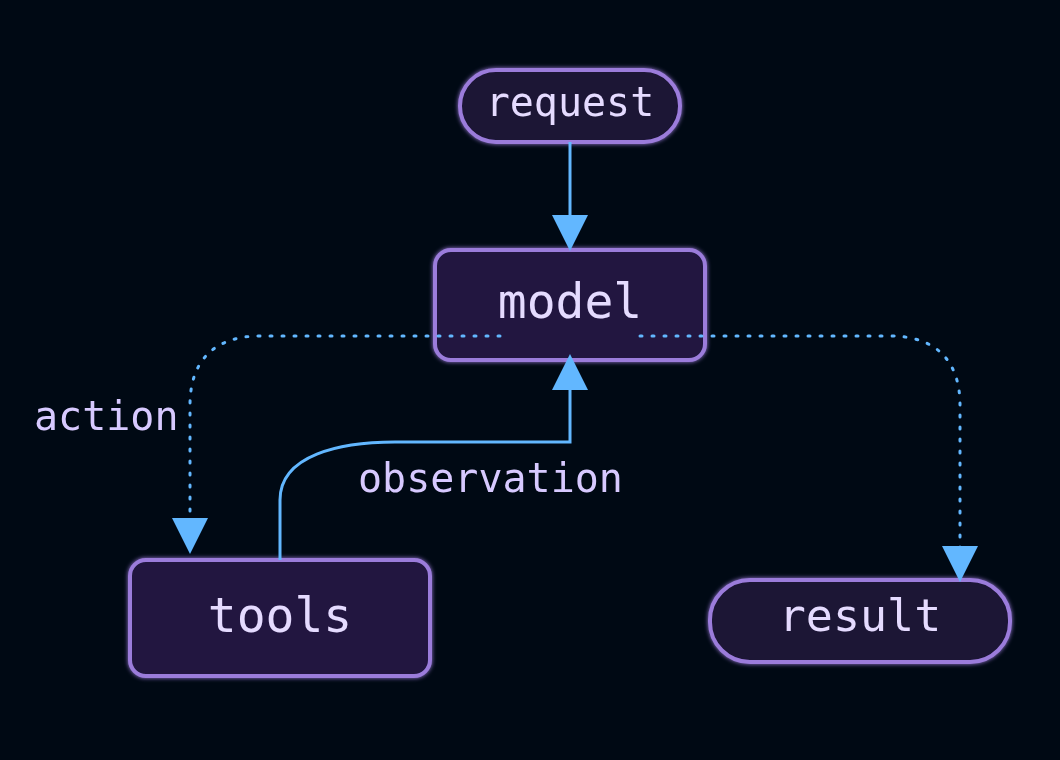
Агент в LangChain — это модель, вызывающая инструменты в цикле до завершения задачи.
Модель (Agent)
Модели — это механизм рассуждений агентов. Они управляют процессом принятия решений агентом, определяя, какие инструменты использовать, как интерпретировать результаты и когда давать окончательный ответ.
Качество и возможности выбранной вами модели напрямую влияют на базовую надежность и производительность вашего агента. Разные модели лучше справляются с разными задачами — одни лучше выполняют сложные инструкции, другие лучше подходят для структурированного мышления, а третьи поддерживают более широкие контекстные окна для обработки большего объема информации.
Стандартные интерфейсы моделей LangChain предоставляют доступ ко множеству различных интеграций с поставщиками, что упрощает экспериментирование и переключение между моделями для поиска оптимального варианта для ваших задач.
Модели можно использовать двумя способами:
- При работе с агентами модели можно задавать динамически при создании агента.
- Автономный режим — модели можно вызывать напрямую (вне цикла работы агента) для таких задач, как генерация текста, классификация или извлечение данных, без необходимости использования агентской платформы.
Один и тот же интерфейс модели работает в обоих контекстах, что дает вам гибкость для начала работы с простыми задачами и масштабирования до более сложных рабочих процессов на основе агентов по мере необходимости.
Инициализация моделей
Используйте init_chat_model для инициализации модели:
from langchain.chat_models import init_chat_model

# OpenAI
model = init_chat_model("gpt-5.5")
# или с параметрами
model = init_chat_model(
    "gpt-5.5",
    temperature=0.5,      # Случайность ответов (0-1)
    max_tokens=1000,      # Макс. токенов в ответе
    timeout=30,           # Таймаут в секундах
    max_retries=6,        # Попытки повтора (по умолчанию 6)
)
Использование в агентах
from langchain.agents import create_agent

# OpenAI
agent = create_agent(model="openai:gpt-5.5", tools=tools)

# Google Gemini
agent = create_agent(model="google_genai:gemini-3.6-flash", tools=tools)

# Claude (Anthropic)
agent = create_agent(model="anthropic:claude-sonnet-5", tools=tools)

# Ollama (локальная модель)
agent = create_agent(model="ollama:north-mini-code-1.0", tools=tools)

# Azure OpenAI
model = init_chat_model(
    "azure_openai:gpt-5.5",
    azure_deployment="my-deployment"
)

# AWS Bedrock
model = init_chat_model(
    "us.anthropic.claude-sonnet-5",
    model_provider="bedrock_converse"
)
Ключевые параметры модели
| Параметр | Описание | Пример |
|---|---|---|
temperature |
Контроль случайности (0-1). Выше = более творческий | 0.5 |
max_tokens |
Макс. токенов в ответе | 1000 |
timeout |
Таймаут ответа в секундах | 30 |
max_retries |
Количество повторных попыток при ошибке | 6 |
model = init_chat_model(
    "claude-sonnet-4-6",
    # Kwargs passed to the model:
    temperature=0.7,
    timeout=30,
    max_tokens=1000,
    max_retries=6,  # Default; increase for unreliable networks
)
Отказоустойчивость
Модели автоматически повторяют неудачные запросы с экспоненциальной задержкой. По умолчанию модели повторяют запросы до 6 раз при сетевых ошибках, превышении лимита запросов (429) и ошибках сервера (5xx). При ошибках клиента, таких как 401 (несанкционированный доступ) или 404, повторные попытки не выполняются.
Для ненадежных сетей увеличьте max_retries:
model = init_chat_model(
    "gpt-5.5",
    max_retries=10,    # Увеличено для ненадежных сетей
    timeout=120,       # Увеличено для медленных соединений
)
Методы вызова моделей
Для генерации выходных данных необходимо вызвать модель чата. Существует три основных метода вызова, каждый из которых подходит для разных сценариев использования.
# Одиночный вызов (ожидает полный ответ)
response = model.invoke("Вопрос?")

# Потоковая передача (получение ответа по частям)
for chunk in model.stream("Вопрос?"):
    print(chunk.text, end="", flush=True)

# Пакетная обработка (несколько запросов параллельно)
responses = model.batch([
    "Вопрос 1?",
    "Вопрос 2?",
    "Вопрос 3?"
])
Самый простой способ вызвать модель — использовать её invoke() с одним сообщением или со списком сообщений. В модель чата можно передать список сообщений, представляющих историю переписки. Каждое сообщение имеет роль, которую модель использует для указания отправителя сообщения в ходе беседы.
conversation = [
    {"role": "system", "content": "You are a helpful assistant that translates English to French."},
    {"role": "user", "content": "Translate: I love programming."},
    {"role": "assistant", "content": "J'adore la programmation."},
    {"role": "user", "content": "Translate: I love building applications."}
]

response = model.invoke(conversation)
print(response)  # AIMessage("J'adore créer des applications.")

# или с объектами LangChain
from langchain.messages import HumanMessage, AIMessage, SystemMessage

conversation = [
    SystemMessage("You are a helpful assistant that translates English to French."),
    HumanMessage("Translate: I love programming."),
    AIMessage("J'adore la programmation."),
    HumanMessage("Translate: I love building applications.")
]

response = model.invoke(conversation)
print(response)  # AIMessage("J'adore créer des applications.")
Пакетная обработка.
Большинство моделей могут передавать свой выходной контент в режиме реального времени во время его генерации. Поэтапное отображение выходного контента значительно улучшает пользовательский опыт, особенно при обработке длинных ответов.
Вызов stream() возвращаетитератор. Это позволяет получать выходные фрагменты по мере их создания. Для обработки каждого фрагмента в режиме реального времени можно использовать цикл:
for chunk in model.stream("Why do parrots have colorful feathers?"):
    print(chunk.text, end="|", flush=True)
В отличие от метода invoke(), который возвращает один объект AIMessage после того, как модель завершит генерацию полного ответа, метод stream() возвращает несколько AIMessageChunk объектов, каждый из которых содержит часть выходного текста. Важно отметить, что каждый фрагмент потока предназначен для объединения в полное сообщение путем суммирования.
full = None  # None | AIMessageChunk
for chunk in model.stream("What color is the sky?"):
    full = chunk if full is None else full + chunk
    print(full.text)

# The
# The sky
# The sky is
# The sky is typically
# The sky is typically blue
# ...

print(full.content_blocks)
# [{"type": "text", "text": "The sky is typically blue..."}]
Полученное сообщение можно обрабатывать так же, как и сообщение, сгенерированное с помощью соответствующего инструмента invoke() — например, его можно объединить в историю сообщений и передать обратно в модель в качестве контекста разговора.
Потоковая обработка работает только в том случае, если все этапы программы умеют обрабатывать поток фрагментов данных. Например, приложение, не поддерживающее потоковую обработку, должно хранить весь вывод в памяти до его обработки.
Пакетная обработка.
Объединение набора независимых запросов к модели в пакеты может значительно повысить производительность и снизить затраты, поскольку обработка может выполняться параллельно:
responses = model.batch([
    "Why do parrots have colorful feathers?",
    "How do airplanes fly?",
    "What is quantum computing?"
])
for response in responses:
    print(response)
По умолчанию batch() будет возвращен только окончательный результат для всей партии. Если вы хотите получать результаты для каждого отдельного входного параметра по мере завершения его генерации, вы можете передавать результаты потоком с помощью batch_as_completed().
for response in model.batch_as_completed([
    "Why do parrots have colorful feathers?",
    "How do airplanes fly?",
    "What is quantum computing?"
]):
    print(response)
При использовании этой функции batch_as_completed() результаты могут поступать в неправильном порядке. Каждый результат включает входной индекс для сопоставления, что позволяет восстановить исходный порядок по мере необходимости.
При обработке большого количества входных данных с помощью batch() или batch_as_completed() может потребоваться ограничить максимальное количество параллельных вызовов. Это можно сделать, установив max_concurrency атрибут в RunnableConfig словаре.
Вызов инструмента (tool)
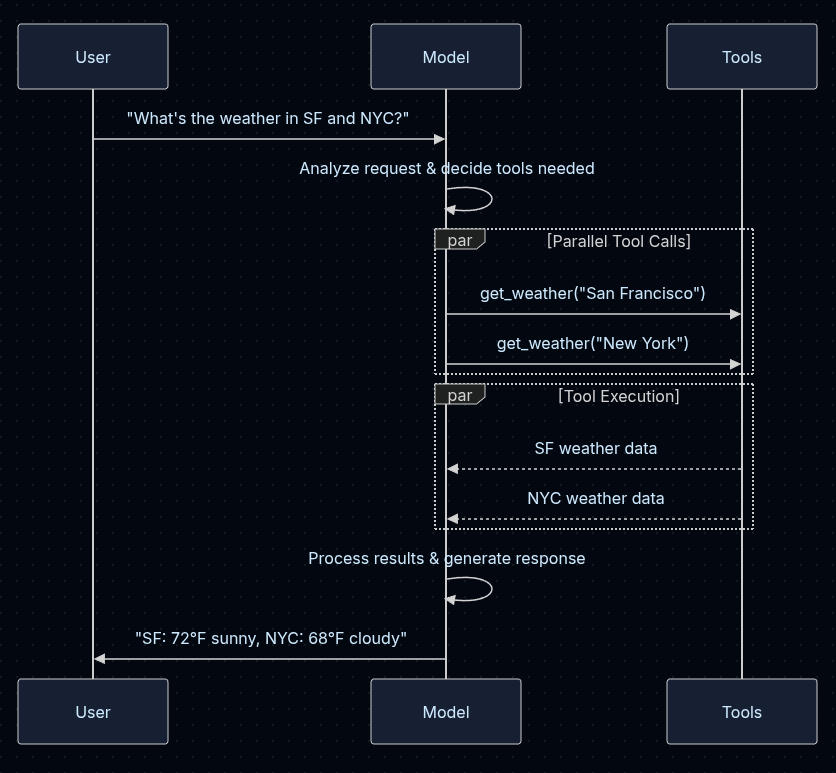
Модели могут запрашивать вызов инструментов, выполняющих такие задачи, как получение данных из базы данных, поиск в интернете или выполнение кода. Инструменты представляют собой пары:
- Схема, включающая название инструмента, описание и/или определения аргументов (часто это JSON-схема).
- Функция или сопрограмма для выполнения
Проверка модели
Модели предоставляют профиль с информацией о возможностях:
model.profile
# {
#   "max_input_tokens": 4096,
#   "tool_calling": True,
#   "structured_output": True,
#   "reasoning_output": True,
#   ...
# }
Привязка инструментов к модели
from langchain.tools import tool

@tool
def search(query: str) -> str:
    """Поиск информации."""
    return f"Результаты для: {query}"

# Привяжите инструменты к модели
model_with_tools = model.bind_tools([search])

response = model_with_tools.invoke("Найди информацию о Python")
print(response.tool_calls)  # Модель решит, использовать ли инструмент
Инструменты (Tools)
Инструменты позволяют модели взаимодействовать с внешними системами. Используйте декоратор @tool:
from langchain.agents import create_agent
from langchain.tools import tool

@tool
def search(query: str) -> str:
    """Поиск информации."""
    return f"Результаты для: {query}"

agent = create_agent(model="openai:gpt-5.5", tools=[search])
Системный промпт (System Prompt)
Определяет поведение и роль агента:
agent = create_agent(
    model="openai:gpt-5.5",
    tools=tools,
    system_prompt="Ты полезный ассистент. Будь точным и кратким.",
)
Структурированный вывод (Structured Output)
Модели могут возвращать ответ в формате, соответствующем заданной схеме. Это полезно для обеспечения возможности легкого анализа и использования выходных данных в последующей обработке. LangChain поддерживает несколько типов схем и методов для обеспечения структурированного вывода.
from pydantic import BaseModel, Field

class Movie(BaseModel):
    """A movie with details."""
    title: str = Field(description="The title of the movie")
    year: int = Field(description="The year the movie was released")
    director: str = Field(description="The director of the movie")
    rating: float = Field(description="The movie's rating out of 10")

model_with_structure = model.with_structured_output(Movie)
response = model_with_structure.invoke("Provide details about the movie Inception")
print(response)  # Movie(title="Inception", year=2010, director="Christopher Nolan", rating=8.8)
Ключевые аспекты структурированного вывода:
json_schemaИспользует специальные функции структурированного вывода, предоставляемые поставщиком.function_calling: Формирует структурированный вывод, принудительно вызывая инструмент, соответствующий заданной схеме.json_mode: Предшественник функции, предлагаемой некоторыми поставщиками. Генерирует корректный JSON, но схема должна быть описана в подсказке.
Включить необработанные данные можно установив параметр include_raw=True, чтобы получить как обработанный результат, так и необработанное сообщение ИИ.
Модели Pydantic обеспечивают автоматическую проверку, TypedDict модели JSON Schema требуют ручной проверки.
Состояние агента (Agent State)
Каждый агент управляет контекстом выполнения через AgentState — типизированный словарь, содержащий историю разговора и пользовательские поля. Добавляйте пользовательские поля через подкласс:
from langchain.agents import AgentState, create_agent

class MyState(AgentState):
    user_id: str
    call_count: int

agent = create_agent(
    model="openai:gpt-5.5",
    tools=[],
    state_schema=MyState,
)
Вызов агента
Вызовите агент с сообщением. Это передаёт обновление в состояние агента. Все агенты включают последовательность сообщений; используйте thread_id для сохранения истории:
from langchain.agents import create_agent
from langchain_core.utils.uuid import uuid7
from langgraph.checkpoint.memory import InMemorySaver

agent = create_agent(
    model="openai:gpt-5.5",
    tools=[],
    checkpointer=InMemorySaver(),
)

config = {"configurable": {"thread_id": str(uuid7())}}

# Первый запрос
result = agent.invoke(
    {"messages": [{"role": "user", "content": "Какая погода в Санкт-Петербурге?"}]},
    config=config,
)

# Следующий запрос в одной беседе — повторно используйте thread_id
result = agent.invoke(
    {"messages": [{"role": "user", "content": "А завтра?"}]},
    config=config,
)
Потоковая передача (Streaming)
Вместо invoke используйте stream_events для получения прогресса в реальном времени:
from langchain.messages import AIMessage, HumanMessage

stream = agent.stream_events(
    {"messages": [{"role": "user", "content": "Поиск новостей об AI..."}]},
    version="v3",
)

for snapshot in stream.values:
    latest_message = snapshot["messages"][-1]
    if latest_message.content:
        if isinstance(latest_message, HumanMessage):
            print(f"Пользователь: {latest_message.content}")
        elif isinstance(latest_message, AIMessage):
            print(f"Агент: {latest_message.content}")
    elif latest_message.tool_calls:
        print(f"Вызовы: {[tc['name'] for tc in latest_message.tool_calls]}")
Конфигурация harness (шаблона агента)
create_agent расширяется через middleware — каждый слой обрабатывает одну проблему и встраивается в цикл агента:
Окружение выполнения (Execution Environment)
Файловая система и выполнение кода:
from langchain.agents import create_agent
from deepagents.backends import StateBackend
from deepagents.middleware import FilesystemMiddleware

agent = create_agent(
    model="openai:gpt-5.5",
    tools=[search],
    middleware=[FilesystemMiddleware(backend=StateBackend())],
)
Управление контекстом (Context Management)
Суммаризация, память и навыки:
from deepagents.middleware import (
    FilesystemMiddleware, SummarizationMiddleware,
    MemoryMiddleware, SkillsMiddleware
)

backend = StateBackend()
agent = create_agent(
    model="openai:gpt-5.5",
    tools=[search],
    middleware=[
        FilesystemMiddleware(backend=backend),
        SummarizationMiddleware(model="openai:gpt-5.5", backend=backend),
        MemoryMiddleware(backend=backend, sources=["./AGENTS.md"]),
        SkillsMiddleware(backend=backend, sources=["./skills/"]),
    ],
)
Отказоустойчивость (Fault Tolerance)
Повторные попытки для ошибок моделей и инструментов:
from langchain.agents.middleware import ModelRetryMiddleware, ToolRetryMiddleware

agent = create_agent(
    model="openai:gpt-5.5",
    tools=[search],
    middleware=[
        ModelRetryMiddleware(max_retries=3),
        ToolRetryMiddleware(max_retries=2),
    ],
)
Защита данных (Guardrails)
Обнаружение и защита персональных данных:
from langchain.agents.middleware import PIIMiddleware

agent = create_agent(
    model="openai:gpt-5.5",
    tools=[search],
    middleware=[PIIMiddleware("email")],
)
Контроль человеком (Steering)
Требовать одобрение перед критичными действиями:
from langchain.agents.middleware import HumanInTheLoopMiddleware

agent = create_agent(
    model="openai:gpt-5.5",
    tools=[search],
    middleware=[HumanInTheLoopMiddleware(interrupt_on={"write_file": True})],
)
Messages
Сообщения — это фундаментальная единица контекста для моделей в LangChain. Они представляют вход и выход моделей, содержа контент и метаданные, необходимые для представления состояния разговора при взаимодействии с LLM.
Каждое сообщение содержит:
- Роль (role) — определяет тип сообщения (system, user, assistant, tool)
- Контент (content) — фактическое содержимое сообщения (текст, изображения, аудио, документы)
- Метаданные — опциональные поля (ID сообщения, использование токенов, провайдер-специфичные данные)
Простейший способ использования сообщений — это создание объектов сообщений и передача их в модель при вызове метода.
from langchain.chat_models import init_chat_model
from langchain.messages import HumanMessage, AIMessage, SystemMessage

model = init_chat_model("gpt-5-nano")

system_msg = SystemMessage("You are a helpful assistant.")
human_msg = HumanMessage("Hello, how are you?")

# Use with chat models
messages = [system_msg, human_msg]
response = model.invoke(messages)  # Returns AIMessage
Многоходовые агенты накапливают длинную историю сообщений.
Текстовые промпты
Текстовые промпты представляют собой строки — идеально подходят для простых задач генерации, где не требуется сохранять историю переписки.
response = model.invoke("Write a haiku about spring")
Используйте текстовые промпты, когда:
- У вас один, отдельный запрос.
- История переписки не нужна.
- Вам нужна минимальная сложность кода.
Промпты сообщений
В качестве альтернативы, вы можете передать в модель список сообщений, предоставив список объектов сообщений.
from langchain.messages import SystemMessage, HumanMessage, AIMessage

messages = [
    SystemMessage("You are a poetry expert"),
    HumanMessage("Write a haiku about spring"),
    AIMessage("Cherry blossoms bloom...")
]
response = model.invoke(messages)
Используйте подсказки сообщений в следующих случаях:
- Управление многоэтапными диалогами
- Работа с мультимодальным контентом (изображения, аудио, файлы)
- Включение системных инструкций
Формат словаря
Вы также можете указывать сообщения непосредственно в формате автозавершения чата OpenAI.
messages = [
    {"role": "system", "content": "You are a poetry expert"},
    {"role": "user", "content": "Write a haiku about spring"},
    {"role": "assistant", "content": "Cherry blossoms bloom..."}
]
response = model.invoke(messages)
Типы сообщений
SystemMessage — начальные инструкции, которые задают поведение модели. Вы можете использовать системное сообщение, чтобы задать тон, определить роль модели и установить правила для ответных действий.
from langchain.messages import SystemMessage, HumanMessage

system_msg = SystemMessage("""
You are a senior Python developer with expertise in web frameworks.
Always provide code examples and explain your reasoning.
Be concise but thorough in your explanations.
""")

messages = [
    system_msg,
    HumanMessage("How do I create a REST API?")
]
response = model.invoke(messages)
HumanMessage — представляет ввод пользователя. Он может содержать текст, изображения, аудио, файлы и любое другое количество мультимодального контента.
from langchain.messages import HumanMessage

# Простой текст
human_msg = HumanMessage("Что такое машинное обучение?")

# С метаданными
human_msg = HumanMessage(
    content="Привет!",
    name="alice",  # Идентификатор пользователя
    id="msg_123"   # Уникальный ID для трассировки
)

response = model.invoke([human_msg])
AIMessage — ответы, генерируемые моделью. Он может включать мультимодальные данные, вызовы инструментов и метаданные, специфичные для поставщика, к которым можно получить доступ позже.
При вызове модели ей возвращаются объекты, содержащие все связанные метаданные в ответе.
Поставщики услуг по-разному оценивают/контекстуализируют типы сообщений, поэтому иногда бывает полезно вручную создать новый AIMessage объект и вставить его в историю сообщений так, как если бы он поступил из модели.
from langchain.messages import AIMessage, SystemMessage, HumanMessage

# Create an AI message manually (e.g., for conversation history)
ai_msg = AIMessage("I'd be happy to help you with that question!")

# Add to conversation history
messages = [
    SystemMessage("You are a helpful assistant"),
    HumanMessage("Can you help me?"),
    ai_msg,  # Insert as if it came from the model
    HumanMessage("Great! What's 2+2?")
]

response = model.invoke(messages)
AIMessage включает:
text— текстовое содержимоеcontent- Исходное содержание сообщения.content_blocks— стандартизированное представление контентаtool_calls— вызовы инструментов, которые сделала модельid- Уникальный идентификатор сообщения (либо автоматически сгенерированный LangChain, либо возвращенный в ответе поставщика).usage_metadata— использование токенов (input_tokens, output_tokens и др.)response_metadata- Метаданные ответа сообщения.
ToolMessage — результаты выполнения инструментов.
Для моделей, поддерживающих вызов инструментов, сообщения ИИ могут содержать информацию о вызовах инструментов. Сообщения инструментов используются для передачи результатов выполнения одного инструмента обратно в модель.
Инструменты позволяют создавать ToolMessage объекты напрямую. Ниже приведён простой пример.
from langchain.messages import AIMessage
from langchain.messages import ToolMessage

# After a model makes a tool call
# (Here, we demonstrate manually creating the messages for brevity)
ai_message = AIMessage(
    content=[],
    tool_calls=[{
        "name": "get_weather",
        "args": {"location": "San Francisco"},
        "id": "call_123"
    }]
)

# Execute tool and create result message
weather_result = "Sunny, 72°F"
tool_message = ToolMessage(
    content=weather_result,
    tool_call_id="call_123"  # Must match the call ID
)

# Continue conversation
messages = [
    HumanMessage("What's the weather in San Francisco?"),
    ai_message,  # Model's tool call
    tool_message,  # Tool execution result
]
response = model.invoke(messages)  # Model processes the result
Форматы сообщений
Объекты сообщений (рекомендуется):
from langchain.messages import SystemMessage, HumanMessage, AIMessage

messages = [
    SystemMessage("Ты поэт"),
    HumanMessage("Напиши хайку о весне"),
    AIMessage("Цветы распускаются...")
]
response = model.invoke(messages)
Словарь (формат OpenAI):
messages = [
    {"role": "system", "content": "Ты поэт"},
    {"role": "user", "content": "Напиши хайку о весне"},
    {"role": "assistant", "content": "Цветы распускаются..."}
]
response = model.invoke(messages)
Простой текст (только для одиночного запроса):
# Это shortcut для HumanMessage
response = model.invoke("Напиши хайку о весне")
Содержимое сообщения
Содержимое сообщения можно рассматривать как полезную нагрузку данных, отправляемых в модель. Сообщения имеют content атрибут с нестрогой типизацией, поддерживающий строки и списки нетипизированных объектов (например, словари). Это позволяет напрямую поддерживать структуры, присущие поставщикам данных, в моделях чата LangChain, такие как мультимодальный контент и другие данные.
Отдельно LangChain предоставляет специальные типы контента для текста, рассуждений, цитат, мультимодальных данных, вызовов серверных инструментов и другого содержимого сообщений.
Модели чата LangChain принимают содержимое сообщения в content атрибуте.
Это может содержать либо:
- Строка
- Список блоков контента в формате, используемом самим поставщиком.
- Список стандартных блоков контента LangChain
Ниже приведён пример использования мультимодальных входных данных:
from langchain.messages import HumanMessage

# String content
human_message = HumanMessage("Hello, how are you?")

# Provider-native format (e.g., OpenAI)
human_message = HumanMessage(content=[
    {"type": "text", "text": "Hello, how are you?"},
    {"type": "image_url", "image_url": {"url": "https://example.com/image.jpg"}}
])

# List of standard content blocks
human_message = HumanMessage(content_blocks=[
    {"type": "text", "text": "Hello, how are you?"},
    {"type": "image", "url": "https://example.com/image.jpg"},
])
Стандартные блоки контента
LangChain предоставляет стандартное представление содержимого сообщений, которое работает у разных поставщиков услуг.
Объекты сообщений реализуют content_blocks свойство, которое позволяет отложенно преобразовывать content атрибут в стандартное, типобезопасное представление. Например, сообщения, сгенерированные из ChatAnthropic или, ChatOpenAI будут включать блоки thinking или reasoning в формате соответствующего поставщика, но могут быть отложенно преобразованы в согласованное ReasoningContentBlock представление:
from langchain.messages import AIMessage

message = AIMessage(
    content=[
        {"type": "thinking", "thinking": "...", "signature": "WaUjzkyp..."},
        {"type": "text", "text": "..."},
    ],
    response_metadata={"model_provider": "anthropic"}
)
message.content_blocks

[{'type': 'reasoning',
  'reasoning': '...',
  'extras': {'signature': 'WaUjzkyp...'}},
 {'type': 'text', 'text': '...'}]
Сообщения поддерживают стандартизированные блоки контента (content_blocks):
| Тип | Описание | Пример |
|---|---|---|
text |
Текстовое содержимое | {"type": "text", "text": "Привет"} |
reasoning |
Reasoning процесс модели | {"type": "reasoning", "reasoning": "..."} |
image |
Изображение | {"type": "image", "url": "..."} |
audio |
Аудио | {"type": "audio", "base64": "..."} |
video |
Видео | {"type": "video", "base64": "..."} |
file |
Документ | {"type": "file", "url": "..."} |
tool_call |
Вызов инструмента | {"type": "tool_call", "name": "search", "id": "call_1"} |
Справочник по блокам контента.
Мультимодальность
Мультимодальность подразумевает способность работать с данными, поступающими в различных формах, таких как текст, аудио, изображения и видео. LangChain включает стандартные типы для этих данных, которые могут использоваться различными поставщиками. Модели чата могут принимать многомодальные данные на вход и генерировать их на выходе.
Сериализация сообщений
Сохраняйте и восстанавливайте историю сообщений:
from langchain.messages import HumanMessage
from langchain_core.load import dumpd, load

message = HumanMessage("Какая столица Франции?")

# Сериализация в словарь
serialized = dumpd(message)

# Десериализация обратно
restored = load(serialized)
Tools
Инструменты — это функции с чётко определённым входом и выходом, которые предоставляют агентам способность получать данные в реальном времени, выполнять код, запрашивать внешние БД и выполнять действия.
Модель решает, когда вызвать инструмент, основываясь на контексте разговора, и какие аргументы передать.
Создание инструментов
Базовое определение инструмента
Используйте декоратор @tool. Docstring функции становится описанием инструмента.
from langchain.tools import tool

@tool
def search_database(query: str, limit: int = 10) -> str:
    """Поиск в базе данных по запросу.

    Args:
        query: Поисковые термины
        limit: Максимум результатов
    """
    return f"Найдено {limit} результатов для '{query}'"
Докстринги обязательны — они определяют схему входа инструмента. Используйте snake_case для имён инструментов (e.g. web_search вместо Web Search).
Пользовательское имя и описание
По умолчанию имя инструмента формируется из имени функции. Переопределите его, когда вам нужно что-то более описательное.
@tool("web_search")  # Пользовательское имя
def search(query: str) -> str:
    """Поиск в сети."""
    return f"Результаты для: {query}"

print(search.name)  # web_search
Так же можно переопределить автоматически сгенерированное описание
@tool("calculator", description="Performs arithmetic calculations. Use this for any math problems.")
def calc(expression: str) -> str:
    """Evaluate mathematical expressions."""
    return str(eval(expression))
Сложная схема входных данных
Определите сложные входные данные с помощью моделей Pydantic или схем JSON:
from pydantic import BaseModel, Field
from typing import Literal

class WeatherInput(BaseModel):
    """Входные данные для запроса о погоде."""
    location: str = Field(description="Название города")
    units: Literal["celsius", "fahrenheit"] = Field(
        default="celsius",
        description="Единица температуры"
    )
    include_forecast: bool = Field(
        default=False,
        description="Включить прогноз на 5 дней"
    )

@tool(args_schema=WeatherInput)
def get_weather(
    location: str, units: str = "celsius",
    include_forecast: bool = False
    ) -> str:
    """Получить погоду и опциональный прогноз."""
    temp = 22 if units == "celsius" else 72
    result = f"Погода в {location}: {temp}° {units[0].upper()}"
    if include_forecast:
        result += "\nСледующие 5 дней: Солнечно"
    return result
Зарезервированные имена аргументов
Следующие имена параметров зарезервированы и не могут использоваться в качестве аргументов инструмента. Использование этих имен приведет к ошибкам во время выполнения.
config- Зарезервировано для передачиRunnableConfigинструментам внутри сессииruntime- Зарезервировано дляToolRuntimeпараметра (доступ к состоянию, контексту, хранилищу)
Чтобы получить доступ к информации о времени выполнения, используйте параметр ToolRuntime вместо именования собственных аргументов config или runtime.
Контекст и состояние
Инструменты наиболее эффективны, когда они могут получить доступ к информации во время выполнения, такой как история разговоров, пользовательские данные и постоянная память.
Инструменты могут получать доступ к информации о времени выполнения через ToolRuntime параметр, который обеспечивает:
- State: кратковременная память — изменяемые данные, существующие для текущего диалога (сообщения, счетчики, настраиваемые поля). Использование: доступ к истории разговоров, отслеживание количества вызовов инструментов.
- Context: неизменяемая конфигурация, передаваемая во время вызова (идентификаторы пользователей, информация о сеансе). Использование: ответы на основе личности пользователя
- Store: долговременная память — постоянные данные, которые сохраняются во время разговоров. Использование: сохраняние предпочтений пользователей, поддержка базы знаний.
- Stream Writer: публикует обновления в реальном времени во время выполнения инструмента. Использование: показать прогресс в долгосрочных операциях.
- Execution Info: идентификационная информация для текущего выполнения (идентификатор потока, идентификатор запуска, номер попытки). Использование: доступ к идентификаторам потоков/запусков, настройка поведения на основе состояния повторной попытки
- Server Info: метаданные, специфичные для сервера
LangGraph(идентификатор помощника, идентификатор графа, аутентифицированный пользователь). - Config:
RunnableConfigдля исполнения. Использование: доступ к колбекам, тегам и метаданным. - ool Call ID: уникальный идентификатор текущего вызова инструмента.
Доступ к состоянию (кратковременная память)
Состояние представляет собой кратковременную память, которая существует на протяжении всего диалога. Оно включает в себя историю сообщений и любые пользовательские поля, которые вы определяете.
Добавьте в свой tool runtime: ToolRuntime для доступа к состоянию. Во время вызова ToolNode автоматически введет значение; параметр не включается в схему, которая отправляется моделли. Используйте runtime.state для чтения текущего состояния разговора:
from langchain.tools import tool, ToolRuntime
from langchain.messages import HumanMessage

@tool
def get_last_message(runtime: ToolRuntime) -> str:
    """Получить последнее сообщение пользователя."""
    messages = runtime.state["messages"]
    for message in reversed(messages):
        if isinstance(message, HumanMessage):
            return message.content
    return "Нет сообщений"

# Доступ к пользовательским полям состояния
@tool
def get_user_preference(pref_name: str, runtime: ToolRuntime) -> str:
    """Получить предпочтение пользователя."""
    preferences = runtime.state.get("user_preferences", {})
    return preferences.get(pref_name, "Not set")
Используйте Command для обновления состояния агента. Это полезно для инструментов, которым необходимо обновлять пользовательские поля состояния. Включите ToolMessage в обновление, чтобы модель могла видеть результат вызова инструмента:
from langchain.agents import AgentState
from langchain.messages import ToolMessage
from langchain.tools import ToolRuntime, tool
from langgraph.types import Command


class CustomState(AgentState):
    user_name: str


@tool
def set_user_name(new_name: str, runtime: ToolRuntime[None, CustomState]) -> Command:
    """Set the user's name in the conversation state."""
    return Command(
        update={
            "user_name": new_name,
            "messages": [
                ToolMessage(
                    content=f"User name set to {new_name}.",
                    tool_call_id=runtime.tool_call_id,
                )
            ],
        }
    )
Когда инструменты обновляют переменные состояния, можно использовать Reducers для этих полей. Поскольку LLM могут вызывать несколько инструментов параллельно, редуктор определяет, как разрешать конфликты, когда одно и то же поле состояния обновляется одновременными вызовами инструментов.
Доступ к контексту
Контекст предоставляет неизменяемые данные конфигурации, которые передаются во время вызова. Используйте его для идентификаторов пользователей, сведений о сеансе или настроек, специфичных для приложения, которые не должны меняться во время разговора.
from dataclasses import dataclass

from langchain.agents import create_agent
from langchain.tools import tool, ToolRuntime
from langchain_core.utils.uuid import uuid7
from langchain_openai import ChatOpenAI
from langgraph.checkpoint.memory import InMemorySaver


USER_DATABASE = {
    "user123": {
        "name": "Alice Johnson",
        "account_type": "Premium",
        "balance": 5000,
        "email": "alice@example.com",
    },
    "user456": {
        "name": "Bob Smith",
        "account_type": "Standard",
        "balance": 1200,
        "email": "bob@example.com",
    },
}


@dataclass
class UserContext:
    user_id: str


@tool
def get_account_info(runtime: ToolRuntime[UserContext]) -> str:
    """Get the current user's account information."""
    user_id = runtime.context.user_id

    if user_id in USER_DATABASE:
        user = USER_DATABASE[user_id]
        return (
            f"Account holder: {user['name']}\n"
            f"Type: {user['account_type']}\n"
            f"Balance: ${user['balance']}"
        )
    return "User not found"


model = ChatOpenAI(model="gpt-5.5")
agent = create_agent(
    model,
    tools=[get_account_info],
    context_schema=UserContext,
    checkpointer=InMemorySaver(),
    system_prompt="You are a financial assistant.",
)

thread_id = str(uuid7())
config = {"configurable": {"thread_id": thread_id}}
context = UserContext(user_id="user123")

result = agent.invoke(
    {"messages": [{"role": "user", "content": "What's my current balance?"}]},
    config=config,
    context=context,
)
print(result["messages"][-1].content_blocks)

result = agent.invoke(
    {"messages": [{"role": "user", "content": "What was my balance again?"}]},
    config=config,
    context=context,
)
print(result["messages"][-1].content_blocks)
Store. Долговременная память (Хранилище)
Обеспечивает постоянное хранилище, которое сохраняется во время разговоров. В отличие от состояния (кратковременной памяти), данные, сохраненные в хранилище, остаются доступными в будущих сеансах.
Доступ в Store через runtime.store. Для организации данных хранилище использует шаблон пространства имен/ключей.
Для производственных развертываний используйте реализацию постоянного хранилища, например PostgresStore, MongoDBStore, или RedisStore вместо InMemoryStore. Подробности настройки см. в документации по памяти.
from langgraph.store.memory import InMemoryStore
from langchain.agents import create_agent
from langchain.tools import tool, ToolRuntime
from langchain_openai import ChatOpenAI

# Access memory
@tool
def get_user_info(user_id: str, runtime: ToolRuntime) -> str:
    """Look up user info."""
    store = runtime.store
    user_info = store.get(("users",), user_id)
    return str(user_info.value) if user_info else "Unknown user"

# Update memory
@tool
def save_user_info(user_id: str, name: str, age: int, email: str, runtime: ToolRuntime) -> str:
    """Save user info."""
    store = runtime.store
    store.put(("users",), user_id, {"name": name, "age": age, "email": email})
    return "Successfully saved user info."

model = ChatOpenAI(model="gpt-5.5")

store = InMemoryStore()
agent = create_agent(
    model,
    tools=[get_user_info, save_user_info],
    store=store
)

# First session: save user info
agent.invoke({
    "messages": [{"role": "user", "content": "Save the following user: userid: abc123, name: Foo, age: 25, email: foo@langchain.dev"}]
})

# Second session: get user info
agent.invoke({
    "messages": [{"role": "user", "content": "Get user info for user with id 'abc123'"}]
})
# Here is the user info for user with ID "abc123":
# - Name: Foo
# - Age: 25
# - Email: foo@langchain.dev
Streaming writing
Передача обновлений в режиме реального времени от инструментов во время выполнения. Это полезно для предоставления пользователям обратной связи о ходе выполнения во время длительных операций.
Используйте runtime.stream_writer для отправки пользовательских обновлений (необходим вызов в контексте выполнения [notes/langgraph]):
from langchain.tools import tool, ToolRuntime

@tool
def get_weather(city: str, runtime: ToolRuntime) -> str:
    """Get weather for a given city."""
    writer = runtime.stream_writer

    # Stream custom updates as the tool executes
    writer(f"Looking up data for city: {city}")
    writer(f"Acquired data for city: {city}")

    return f"It's always sunny in {city}!"
Информация о runtime и сервере ДфтпПкфзр
from langchain.tools import tool, ToolRuntime

@tool
def log_execution_context(runtime: ToolRuntime) -> str:
    """Log execution identity information."""
    info = runtime.execution_info
    print(f"Thread: {info.thread_id}, Run: {info.run_id}")
    print(f"Attempt: {info.node_attempt}")
    return "done"
from langchain.tools import tool, ToolRuntime

@tool
def get_assistant_scoped_data(runtime: ToolRuntime) -> str:
    """Fetch data scoped to the current assistant."""
    server = runtime.server_info
    if server is not None:
        print(f"Assistant: {server.assistant_id}, Graph: {server.graph_id}")
        if server.user is not None:
            print(f"User: {server.user.identity}")
    return "done"
Выполнение инструмента
В LangChain инструменты используются агентами (например, через create_agent), а обработка ошибок инструментов настраивается через промежуточное ПО .
Для рабочих процессов LangGraph выполнение инструментов осуществляется с помощью ToolNode.
Возвращаемые значения инструментов
Вы можете выбрать различные возвращаемые значения для своих инструментов:
- Возвращает значение a string для получения результатов в удобочитаемом формате.
- Возвращает object структурированный результат, который модель должна обработать.
- Возвращает значение
Commandс необязательным сообщением, когда необходимо записать данные в состояние.
Для простых текстовых результатов:
@tool
def get_weather(city: str) -> str:
    """Получить погоду для города."""
    return f"В {city} солнечно."
Поведение: Возвращаемое значение преобразуется в ToolMessage. Модель видит этот текст и решает, что делать дальше. Поля состояния агента не изменяются, если только это не будет сделано позже моделью или другим инструментом. Используйте этот метод, когда в результате получается текст, естественно читаемый человеком.
Для структурированных данных - вохвращаемый объект (например, dict), когда ваш инструмент генерирует структурированные данные, которые модель должна проверить:
@tool
def get_weather_data(city: str) -> dict:
    """Получить структурированные данные о погоде."""
    return {
        "city": city,
        "temperature_c": 22,
        "conditions": "sunny",
    }
Поведение: Объект сериализуется и отправляется обратно в качестве выходных данных инструмента. Модель может считывать определенные поля и рассуждать на их основе. Подобно возвращаемым строкам, это не обновляет состояние графа напрямую. Используйте это, когда для дальнейшего анализа данных предпочтительнее использовать явно заданные поля, а не произвольный текст.
Для возврата мультимодального контента. Инструменты не ограничиваются обычным текстом. Если модель поддерживает многомодальные результаты работы инструмента, он может возвращать стандартные блоки контента, так что модель получает текст, изображения и другие медиафайлы в одном результате.
from langchain.tools import tool


@tool
def capture_screenshot() -> list[dict]:
    """Capture a screenshot of the current page."""
    return [
        {"type": "text", "text": "Screenshot of the current page:"},
        {"type": "image", "url": "https://example.com/page.png"},
    ]
Поведение: Возвращаемое значение преобразуется в ToolMessage многомодальный формат content. Используйте message.content_blocks для чтения нормализованного списка блоков после запуска инструмента. Модель должна поддерживать возвращаемые вами форматы данных. Перед возвратом изображений, аудио или видео проверьте возможности вашей модели. Информацию о типах блоков и требованиях, специфичных для конкретного поставщика услуг. Инструменты MCP, возвращающие изображения или смешанный контент, преобразуются одинаково.
Когда инструмент должен обновить состояние агента.
Command возвращает значение, когда инструменту необходимо обновить состояние графа (например, установить пользовательские настройки или состояние приложения). Если обновление Command нацелено на текущий граф, в него включается объект ToolMessage, идентификатор вызова которого соответствует текущему вызову инструмента. Каждый вызов инструмента в истории сообщений должен иметь соответствующий объект ToolMessage. Используйте runtime.tool_call_id параметр, который обеспечивает выполнение следующего требования: если для обновления нет соответствующего ToolMessage, он сгенерирует исключение ValueError.
from langchain.messages import ToolMessage
from langchain.tools import ToolRuntime, tool
from langgraph.types import Command

@tool
def set_language(language: str, runtime: ToolRuntime) -> Command:
    """Установить предпочитаемый язык."""
    return Command(
        update={
            "preferred_language": language,
            "messages": [
                ToolMessage(
                    content=f"Язык установлен на {language}",
                    tool_call_id=runtime.tool_call_id,
                )
            ],
        }
    )
Поведение: Эта команда обновляет состояние с помощью update. Обновленное состояние доступно последующим шагам в рамках того же выполнения. Используйте редукторы для полей, которые могут обновляться при параллельных вызовах инструментов. Используйте это, когда инструмент не просто возвращает данные, но и изменяет состояние агента.
Return Direct — прямой возврат без дополнительного вызова модели
Установите параметр «Возврат напрямую» для инструмента, чтобы обойти цикл работы агента: агент немедленно возвращает выходные данные инструмента вызывающей стороне, не отправляя их обратно через модель для дальнейшей обработки.
from langchain.agents import create_agent
from langchain.tools import tool
from langchain_openai import ChatOpenAI


@tool(return_direct=True)
def fetch_order_status(order_id: str) -> str:
    """Fetch the current status of a customer order."""
    # In production, query your order management system here
    return f"Order {order_id} is shipped and will arrive in 2 days."


agent = create_agent(
    ChatOpenAI(model="gpt-4o-mini"),
    tools=[fetch_order_status],
)

result = agent.invoke({
    "messages": [{"role": "user", "content": "What is the status of order #12345?"}]
})
# The agent returns the tool output directly without another LLM call:
# "Order 12345 is shipped and will arrive in 2 days."
Поведение: Инструмент работает в обычном режиме, а его вывод заключен в тег ToolMessage. Агент прекращает цикл и возвращает результат работы инструмента в качестве окончательного ответа, минуя любые дополнительные вызовы модели.
Многократные параллельные вызовы инструментов: Когда модель вызывает несколько инструментов за один шаг, сначала выполняются все они. После завершения работы всех инструментов агент перенаправляет запрос END только в том случае, если каждый инструмент в этой группе выполнил необходимые действия return_direct=True. Окончательный ответ включает выходные данные каждого инструмента, вызванного на этом шаге.
Используйте это, когда:
- Результатом работы инструмента является полный, готовый к отображению ответ (например, поисковый запрос, возвращающий готовый к показу результат). Следует избегать лишнего вызова модели, когда дополнительные рассуждения не требуются.
- Вам необходимы детерминированные, неизмененные выходные данные: модель не может перефразировать, обобщать или использовать результаты работы инструмента.
Поскольку данная модель не обрабатывает выходные данные инструмента, она не подходит для инструментов, результаты которых требуют дальнейшего анализа, обобщения или связывания с вызовами других инструментов.
Смешанные параллельные вызовы: если модель вызывает return_direct=True инструмент одновременно с инструментами, которые не имеют return_direct=True, агент не завершает работу после этого шага. Он перенаправляет запрос обратно в модель с каждым вызовом из пакета, чтобы модель могла проанализировать все результаты. Завершение цикла происходит только тогда, когда каждый вызов инструмента на шаге имеет return_direct=True.
Инструмент return_direct=True также может возвращать значение Command для обновления состояния графа перед завершением работы агента. В отличие от обычного возвращаемого значения, значение Command не преобразуется автоматически в ToolMessage. Когда целевой объект находится в текущем графе, включите сопоставление вызова инструмента tool_call_id. Отсутствие этого значения приводит ToolNode к возникновению ошибки ValueError, поскольку каждый AIMessage вызов инструмента должен иметь соответствующее значение ToolMessage в истории сообщений.
from langchain.messages import ToolMessage
from langchain.tools import ToolRuntime, tool
from langgraph.types import Command


@tool(return_direct=True)
def fetch_and_store_order(order_id: str, runtime: ToolRuntime) -> Command:
    """Fetch order status and store it in state."""
    status = f"Order {order_id} is shipped and will arrive in 2 days."
    return Command(
        update={
            "last_order_status": status,
            # Must include a ToolMessage so the message history stays valid
            "messages": [
                ToolMessage(
                    content=status,
                    tool_call_id=runtime.tool_call_id,
                )
            ],
        }
    )
Чтобы записывать данные в родительский граф, установите значение graph=Command.PARENT. В этом случае требование снимается, поскольку выполнение полностью покидает текущий граф.
Обработка ошибок инструментов
Обработка ошибок инструментов с помощью промежуточного ПО агента LangChain позволяет повторять неудачные вызовы инструментов или возвращать пользовательские сообщения об ошибках:
from collections.abc import Callable

from langchain.agents import create_agent
from langchain.agents.middleware import wrap_tool_call
from langchain.messages import ToolMessage
from langchain.tools.tool_node import ToolCallRequest


@wrap_tool_call
def handle_tool_errors(
    request: ToolCallRequest,
    handler: Callable[[ToolCallRequest], ToolMessage],
) -> ToolMessage:
    """Convert tool exceptions into ToolMessages the model can handle."""
    try:
        return handler(request)
    except Exception as e:
        return ToolMessage(
            content=f"Tool error: Please check your input and try again. ({e})",
            tool_call_id=request.tool_call["id"],
        )


agent = create_agent(
    model="ollama:north-mini-code-1.0",
    tools=[],
    middleware=[handle_tool_errors],
)
Динамический выбор инструментов
При использовании динамических инструментов набор инструментов, доступных агенту, изменяется во время выполнения, а не определяется заранее. Не каждый инструмент подходит для каждой ситуации. Слишком много инструментов может перегрузить модель (перегрузить контекст) и увеличить количество ошибок; слишком мало ограничивает возможности. Динамический выбор инструментов позволяет адаптировать доступный набор инструментов в зависимости от состояния аутентификации, прав пользователя, флагов функций или этапа диалога.
Существует два подхода, в зависимости от того, известны ли инструменты заранее:
- Фильтрация предварительно зарегистрированных инструментов
- Регистрация инструмента выполнения
Когда все возможные инструменты известны на этапе создания агента, вы можете предварительно зарегистрировать их и динамически фильтровать, какие из них будут доступны модели, на основе состояния, разрешений или контекста. Например штатный пример (реализация для Store и Context отличается):
from langchain.agents import create_agent
from langchain.agents.middleware import wrap_model_call, ModelRequest, ModelResponse
from typing import Callable

@wrap_model_call
def state_based_tools(
    request: ModelRequest,
    handler: Callable[[ModelRequest], ModelResponse]
) -> ModelResponse:
    """Filter tools based on conversation State."""
    # Read from State: check if user has authenticated
    state = request.state
    is_authenticated = state.get("authenticated", False)
    message_count = len(state["messages"])

    # Only enable sensitive tools after authentication
    if not is_authenticated:
        tools = [t for t in request.tools if t.name.startswith("public_")]
        request = request.override(tools=tools)
    elif message_count < 5:
        # Limit tools early in conversation
        tools = [t for t in request.tools if t.name != "advanced_search"]
        request = request.override(tools=tools)

    return handler(request)

agent = create_agent(
    model="gpt-5.5",
    tools=[public_search, private_search, advanced_search],
    middleware=[state_based_tools]
)
Этот подход наиболее эффективен в следующих случаях:
- Все возможные инструменты известны на этапе компиляции/запуска.
- Вы хотите выполнить фильтрацию на основе разрешений, флагов функций или состояния беседы.
- Инструменты статичны, но их доступность динамична.
Встроенные и MCP инструменты
LangChain предоставляет обширную коллекцию готовых инструментов и инструментариев для решения распространенных задач, таких как веб-поиск, интерпретация кода, доступ к базам данных и многое другое. Эти готовые к использованию инструменты можно напрямую интегрировать в ваши агенты без написания собственного кода.
Полный список доступных инструментов, отсортированных по категориям, можно найти на странице интеграции инструментов и наборов инструментов.
Встроенные инструменты (Server-side)
В некоторых моделях чата есть встроенные инструменты, которые выполняются на стороне сервера поставщиком модели. К ним относятся такие возможности, как веб-поиск и интерпретаторы кода, которые не требуют от вас определения или размещения логики этих инструментов.
# Включите встроенные инструменты через параметры модели
# (см. документацию провайдера)
Инструменты из MCP серверов
Протокол контекста модели (MCP) — это открытый протокол, стандартизирующий способ предоставления приложениями инструментов языковым моделям. Вместо того чтобы создавать инструмент вручную, вы подключаетесь к серверу MCP и адаптируете рекламируемые им инструменты в инструменты LangChain, готовые к передаче агенту, как и любой другой инструмент.
MCPAdapter обнаруживает инструменты сервера и преобразует их в инструменты LangChain. Открывает адаптер, вызывает метод list_tools() и передает результат методу create_agent:
from langchain.agents import create_agent
from langchain.mcp import MCPAdapter

async with MCPAdapter("https://example.com/mcp") as adapter:
    tools = await adapter.list_tools()
    agent = create_agent("claude-sonnet-4-6", tools)
Сравнение LangChain и [notes/deepagents]
| Функция | LangChain Agents | Deep Agents |
|---|---|---|
| Базовые агенты | ✓ | ✓ |
| Инструменты | ✓ | ✓ |
| Память | ✓ | ✓ |
| Планирование | Нужно реализовать | Встроено |
| Файловая система | Нужно реализовать | Встроено |
| Подагенты | Нужно реализовать | Встроено |
Используйте Deep Agents для максимальной функциональности с минимальной настройкой, и LangChain Agents для точного контроля.
Трассировка с LangSmith
LangSmith позволяет отслеживать вызовы агентов и отлаживать их работу.
Зарегистрируйтесь на LangSmith и установите переменные окружения:
export LANGSMITH_TRACING="true"
export LANGSMITH_API_KEY="your-api-key"
Теперь все вызовы вашего агента будут логироваться в LangSmith, и вы сможете видеть полный процесс выполнения.
Рекомендуется также настроить LangSmith Engine для мониторинга следов, обнаружения проблем и предложения исправлений.
Поддерживаемые провайдеры
LangChain работает со множеством провайдеров:
- OpenAI - GPT-4, GPT-3.5
- Google - Gemini, PaLM
- Anthropic - Claude
- Open Source - Ollama, Hugging Face
- Облачные - Azure OpenAI, AWS Bedrock
- Другие - OpenRouter, Fireworks, Baseten
Полезные ресурсы
AI-warning
✨ Данная статья сгенерирована с помощью Claude Haiku 4.5. Текст проверен человеком.